简介
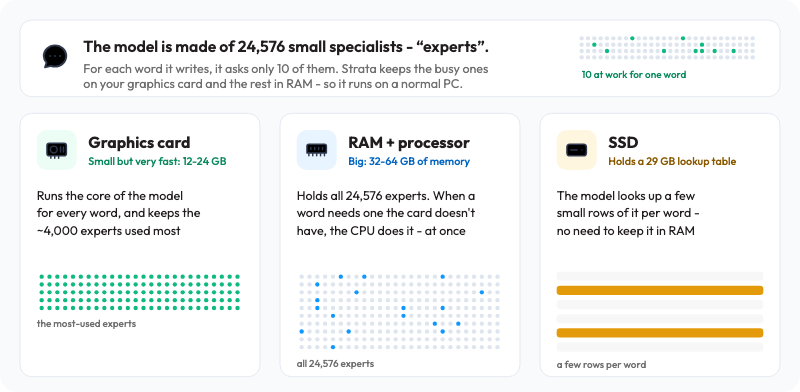
2026 年 9 月在 GitHub 开源的本地推理引擎,用到 llama.cpp / ggml 的部分代码,专门用来跑 125B 参数的 Qwen3.8-Flash-Next:最常用的几千个专家放在显存,全部专家放在内存,SSD 上放一张查找表。项目说明称 12GB 以上显存的 NVIDIA 或 AMD 显卡、32GB 以上内存就能运行。10-14 期徐文浩介绍了这套分层做法,并说自己还没有验证。
提及
在 1 期中被提到
点时间从该处收听
2026 年 9 月在 GitHub 开源的本地推理引擎,用到 llama.cpp / ggml 的部分代码,专门用来跑 125B 参数的 Qwen3.8-Flash-Next:最常用的几千个专家放在显存,全部专家放在内存,SSD 上放一张查找表。项目说明称 12GB 以上显存的 NVIDIA 或 AMD 显卡、32GB 以上内存就能运行。10-14 期徐文浩介绍了这套分层做法,并说自己还没有验证。
在 1 期中被提到
点时间从该处收听